

Vollständig
Das Audit zeigt je Feld, wie viel gefüllt ist. Ein Agent, der das weiß, kann eine Lücke nennen, statt sie zu verschweigen.
Schlechte Daten kosten jeden Tag Zeit: Zahlen werden gesucht, abgeglichen und in Excel nachgebaut. Wir sehen uns Ihr Data Warehouse oder Ihre SQL-Datenbank an, nur lesend, und zeigen, wo die Daten heute nicht tragen. Danach wissen Sie, welche Maßnahme wie viel bringt, was sie kostet und wann sie sich rechnet. Was davon umgesetzt wird, entscheiden Sie.
Datenqualität verbessert man in vier Schritten: messen, Ursachen zuordnen, an der Quelle beheben und wieder messen. Am Anfang steht ein Regelkatalog. Er hält fest, was aktuell, vollständig, plausibel, eindeutig, stimmig und beschrieben sein muss. Der Abstand zum Ziel zeigt, wo sich Arbeit lohnt. Daraus wird eine Liste von Maßnahmen mit Aufwand und Gegenwert in Euro. Das ist auch die Voraussetzung für KI-Agenten: Ein Agent antwortet nur so gut wie die Daten, auf denen er arbeitet.
Genau das ist unser Datenqualitätsaudit. Wir greifen nur lesend auf Ihr Data Warehouse oder Ihre SQL-Datenbank zu und holen nur Zählwerte: Anzahl, Anteile, Ladezeitpunkte. Einzelne Sätze verlassen Ihre Datenbank nicht. Wie wir messen, steht im Kapitel Datenqualität messen des Agentic BI Guide.
Die meisten Teams merken es an den Berichten, nicht an den Daten. Vier Anzeichen sind typisch.
Kommt ein Ladelauf verspätet, zeigt der Bericht es nicht. Erst wenn jemand seine eigene Liste daneben legt, fällt der alte Stand auf.
Kunden ohne Branche, Artikel ohne Warengruppe. Jede Auswertung nach diesem Feld lässt diese Sätze still weg.
Controlling und Fachbereich nennen für denselben Monat verschiedene Umsätze. Bevor entschieden wird, wird erst gerechnet, wer recht hat.
Was „Status 3“ heißt, weiß nur, wer die Tabelle gebaut hat. Wer eine Zahl verstehen will, muss fragen.
Ein Agent arbeitet auf denselben Daten wie Ihr Bericht. Lücken sieht er nicht, er rechnet mit ihnen.
Weil ein Agent jede Lücke weitergibt, schneller und überzeugender als ein Bericht. Fehlt ein Pflichtfeld bei der Hälfte der Sätze, rechnet er mit der anderen Hälfte und sagt es nicht dazu. Ist ein Ladelauf ausgefallen, antwortet er mit einem alten Stand. Ist eine Spalte nicht beschrieben, rät er, was sie bedeutet.
Wer im Fachbereich mit den Zahlen arbeitet, merkt so etwas oft. Ein Agent merkt es nicht. Deshalb liefert das Audit genau das, was ein Agent braucht, um eine Lücke zu nennen statt sie zu überdecken. Wie Agenten falsche Antworten erzeugen und wie man sie verhindert, zeigt das Kapitel KI-Halluzination.
Das Audit zeigt je Feld, wie viel gefüllt ist. Ein Agent, der das weiß, kann eine Lücke nennen, statt sie zu verschweigen.
Tabellen und Spalten tragen eine Beschreibung. Ein Agent muss nicht raten, was ein Feld bedeutet, und Copilot findet die richtige Spalte.
Das Monitoring zeigt den Ladestand je Tabelle. Ein Agent kann sagen, von wann seine Zahlen sind.
Jede Stufe ist einzeln wählbar. Die meisten beginnen mit dem Audit und entscheiden danach je Maßnahme.
Die Prüfung ist SQL in Ihrer Datenbank: je Regel eine Abfrage, die zählt. ABIS liest den SQL-Code als Dateien ein und baut daraus den Graphen der Abhängigkeiten. Er zeigt, wie viele Objekte eine Änderung trifft, und damit den Testaufwand je Maßnahme. Das Monitoring ist ein gewöhnlicher Power-BI-Bericht.
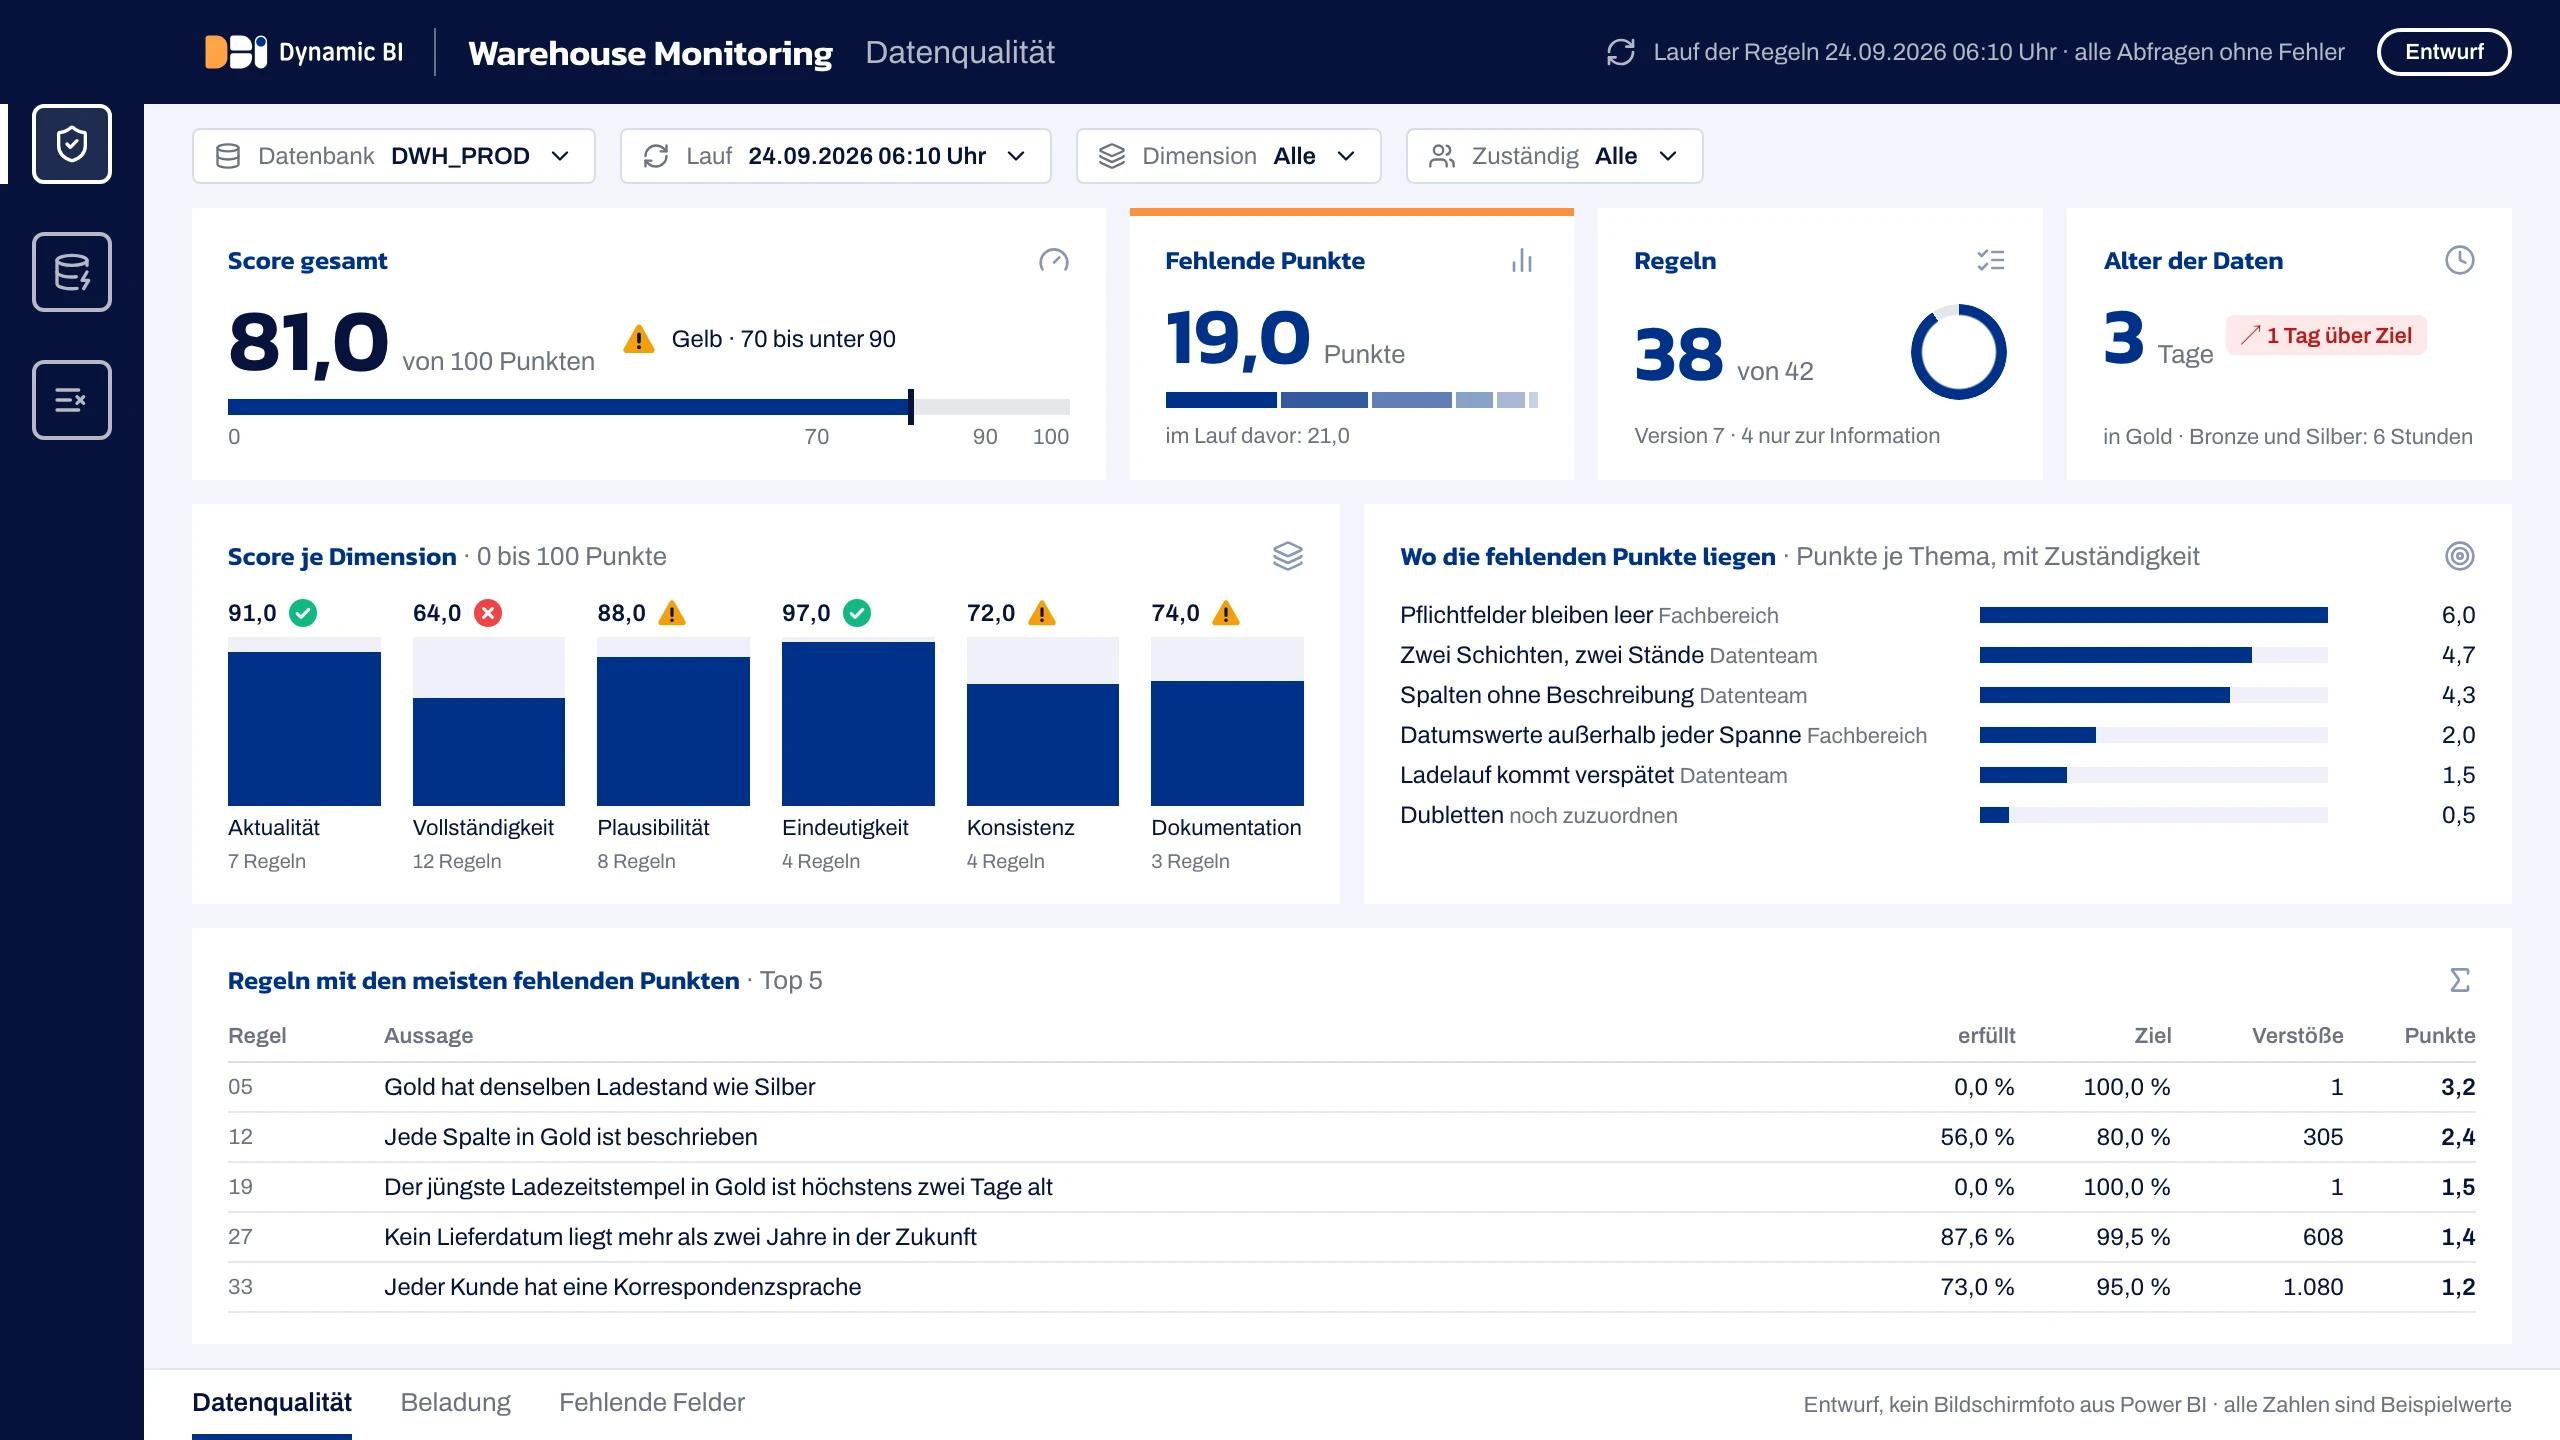
Regelkatalog für eine Datenbank oder ein Datenprodukt, zwei Läufe, Score je Dimension, Befunde mit Rückfragen und eine Maßnahmenliste mit Gegenwert in Euro. Zum Abschluss eine Ergebnisbesprechung.
Voraussetzung: ein lesender Zugang. Einzelne Sätze sehen wir nicht.
Wir setzen um, was Sie freigeben und was im Code liegt: Views, Tests, Beschreibungen, Abgleiche. Jede Maßnahme hat einen Aufwand in Personentagen, den Preis nennen wir mit der Maßnahmenliste.
Nachweis: Der Regelkatalog läuft nach jeder Maßnahme neu.
Ein Bericht zeigt jeden Tag, wann jede Tabelle zuletzt geladen wurde. Danach kommen die Pflichtfelder dazu, die der Fachbereich braucht: wer was nachpflegen muss, je Team.
Das Monitoring ist ein Power-BI-Bericht, keine Funktion von ABIS.
Wir klären, welche Datenbank oder welches Datenprodukt geprüft wird und wer mit den Zahlen arbeitet. Sie richten einen lesenden Zugang ein. Schreiben können wir nicht.
Wie wir messenWir lesen Schemata, Tabellen, Views und Spalten, dazu die Abhängigkeiten im Code. Daraus entsteht der Graph, der zeigt, was wovon abhängt.
Je Regel ein Satz in Ihrer Sprache, eine Dimension und ein Zielwert. Ein Zielwert bleibt ein Vorschlag, bis Ihr Fachbereich ihn bestätigt.
Je Regel eine Abfrage, die zählt: geprüft, verletzt, erfüllter Anteil. Daraus entsteht der Score je Dimension und gesamt. Gelesen werden nur Zählwerte.
Jeder Befund ist als gesichert, offen oder Annahme gekennzeichnet. Wo die Daten eine Frage nicht beantworten, fragen wir nach, statt zu raten. Nach Ihren Antworten läuft der Katalog ein zweites Mal, und dieser Lauf ist die Ausgangslage.
Jede Maßnahme mit Grund, Wirkung in Punkten, Aufwand in Personentagen und Gegenwert in Euro. Sie entscheiden Ja oder Nein. Der nächste Lauf zeigt, was die Umsetzung gebracht hat.
eine Datenbank oder ein Datenprodukt
Aufwand in Personentagen, Preis mit der Maßnahmenliste
danach Betrieb in Ihrem Team
Ein Beispiel mit erfundenen Zahlen, aus keinem Projekt. Es zeigt, wie aus dem Abstand zum Ziel eine Entscheidung wird und ob sich die Maßnahmen im ersten Jahr rechnen.
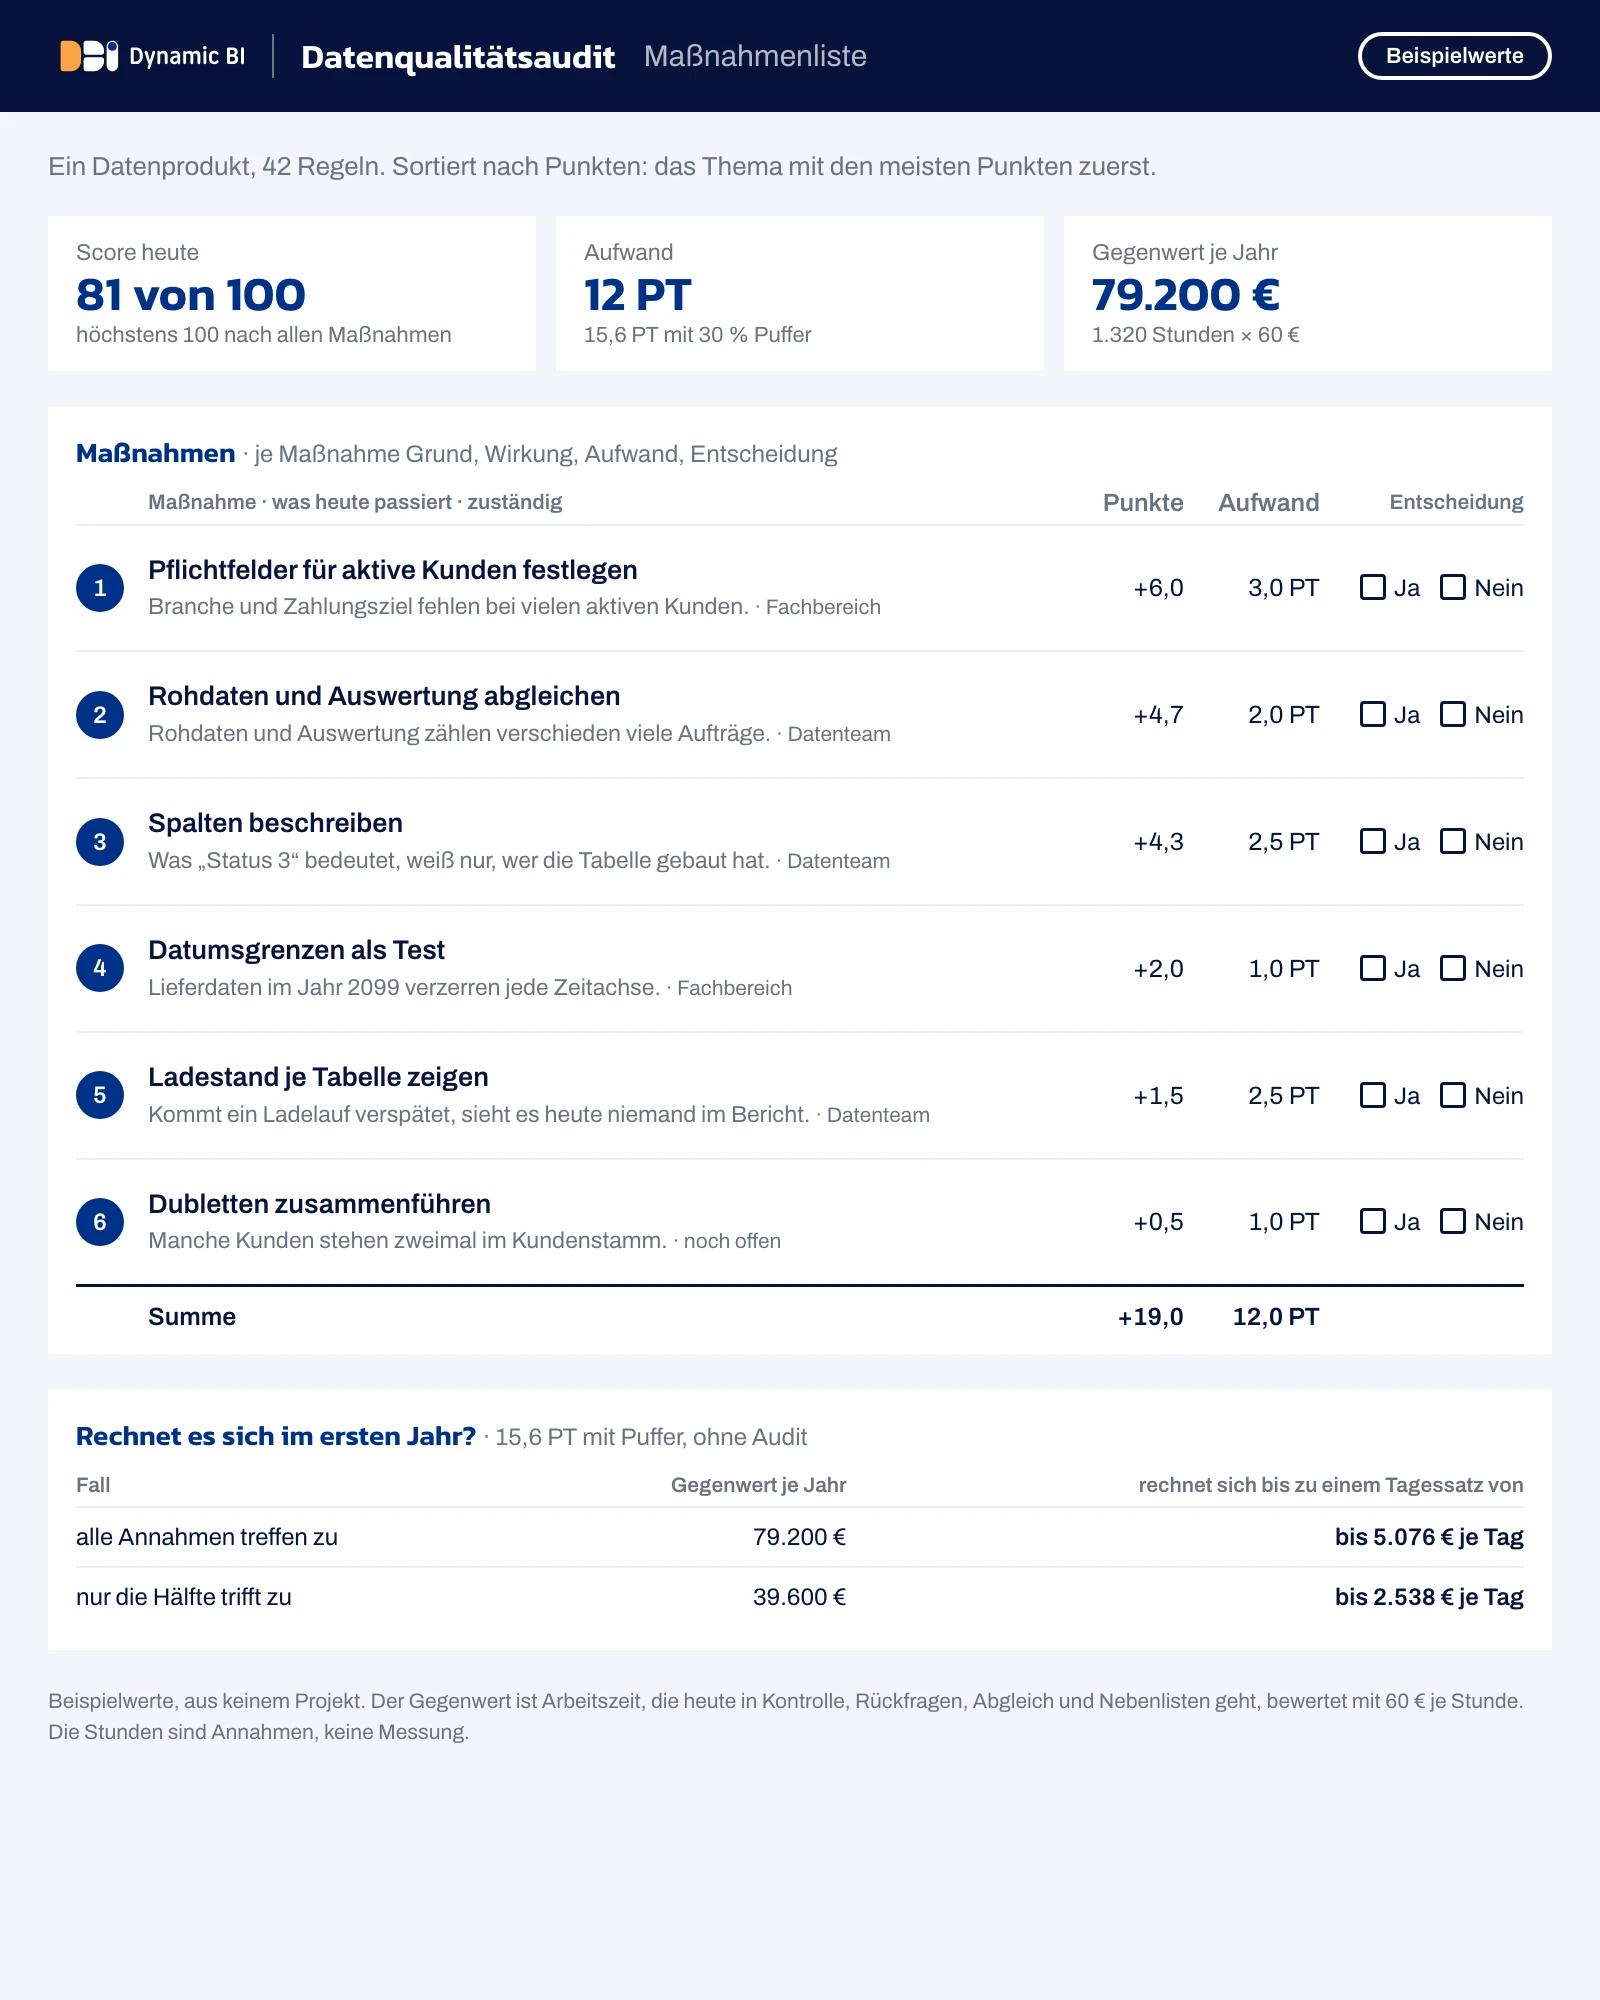
Ein Datenprodukt mit 42 Regeln steht bei 81 von 100 Punkten. Die 19 fehlenden Punkte verteilen sich auf sechs Maßnahmen, zusammen 12 Personentage, mit Puffer 15,6. Der Gegenwert ist Arbeitszeit, die heute in Kontrolle, Rückfragen, Abgleich und Nebenlisten geht: 1.320 Stunden im Jahr, mit 60 € je Stunde 79.200 €. Trifft nur die Hälfte zu, rechnen sich die Maßnahmen im ersten Jahr bis zu einem Tagessatz von 2.538 €. Das Audit ist nicht eingerechnet, die Stunden sind Annahmen.
Rufen Sie direkt an. Kein Formular, keine Rückruf-Schleife: Sie sprechen mit jemandem, der diese Leistung aus Projekten kennt.
David ChangGründer & Datenarchitekt · Agentic BI, Microsoft Fabric
Direkt anrufen+49 89 21542466Wie aus Regeln ein Score wird, wer welchen Fehler behebt, wie Regeln als Tests bei jedem Lauf laufen und wie eine Fehlerliste im Power-BI-Modell aussieht: vier Kapitel aus dem Agentic BI Guide zum Verfahren.
In 30 Minuten klären wir, welche Datenbank geprüft wird, welche Regeln zuerst zählen und wovon der Festpreis abhängt. Keine Vertragsbindung.