ServicesAlle Leistungen→
- Power BI BeratungZielarchitektur, Lizenzen und Governance klären.
- Business Intelligence BeratungStrategie und Kennzahlen, werkzeugunabhängig.
- Digitalisierung mit KIDer Weg ins KI-Zeitalter — mit 90-Minuten-Basiskurs.
- Prozesse mit KI automatisierenErst messen, dann automatisieren — die Reihenfolge, die sich rechnet.
- Copilot-DiscoveryCopilot-Tauglichkeit empirisch prüfen — Festpreis inkl. PoC.
- Excel nach Power BITabellen-Wildwuchs in ein Modell überführen.
- Tableau nach Power BILizenzkosten senken, Logik erhalten.
- Power BI MigrationSSRS und Altsysteme dokumentiert ablösen.
- Power BI × SnowflakeKennzahlen als Views nach Snowflake, DAX nur, wo nötig.
- Microsoft Fabric BeratungLakehouse-Architektur mit klarem Zielbild.
Agentic BI GuideAlle Kapitel→
- MCP erklärtWie KI-Agenten an Power BI, SQL und Excel andocken.
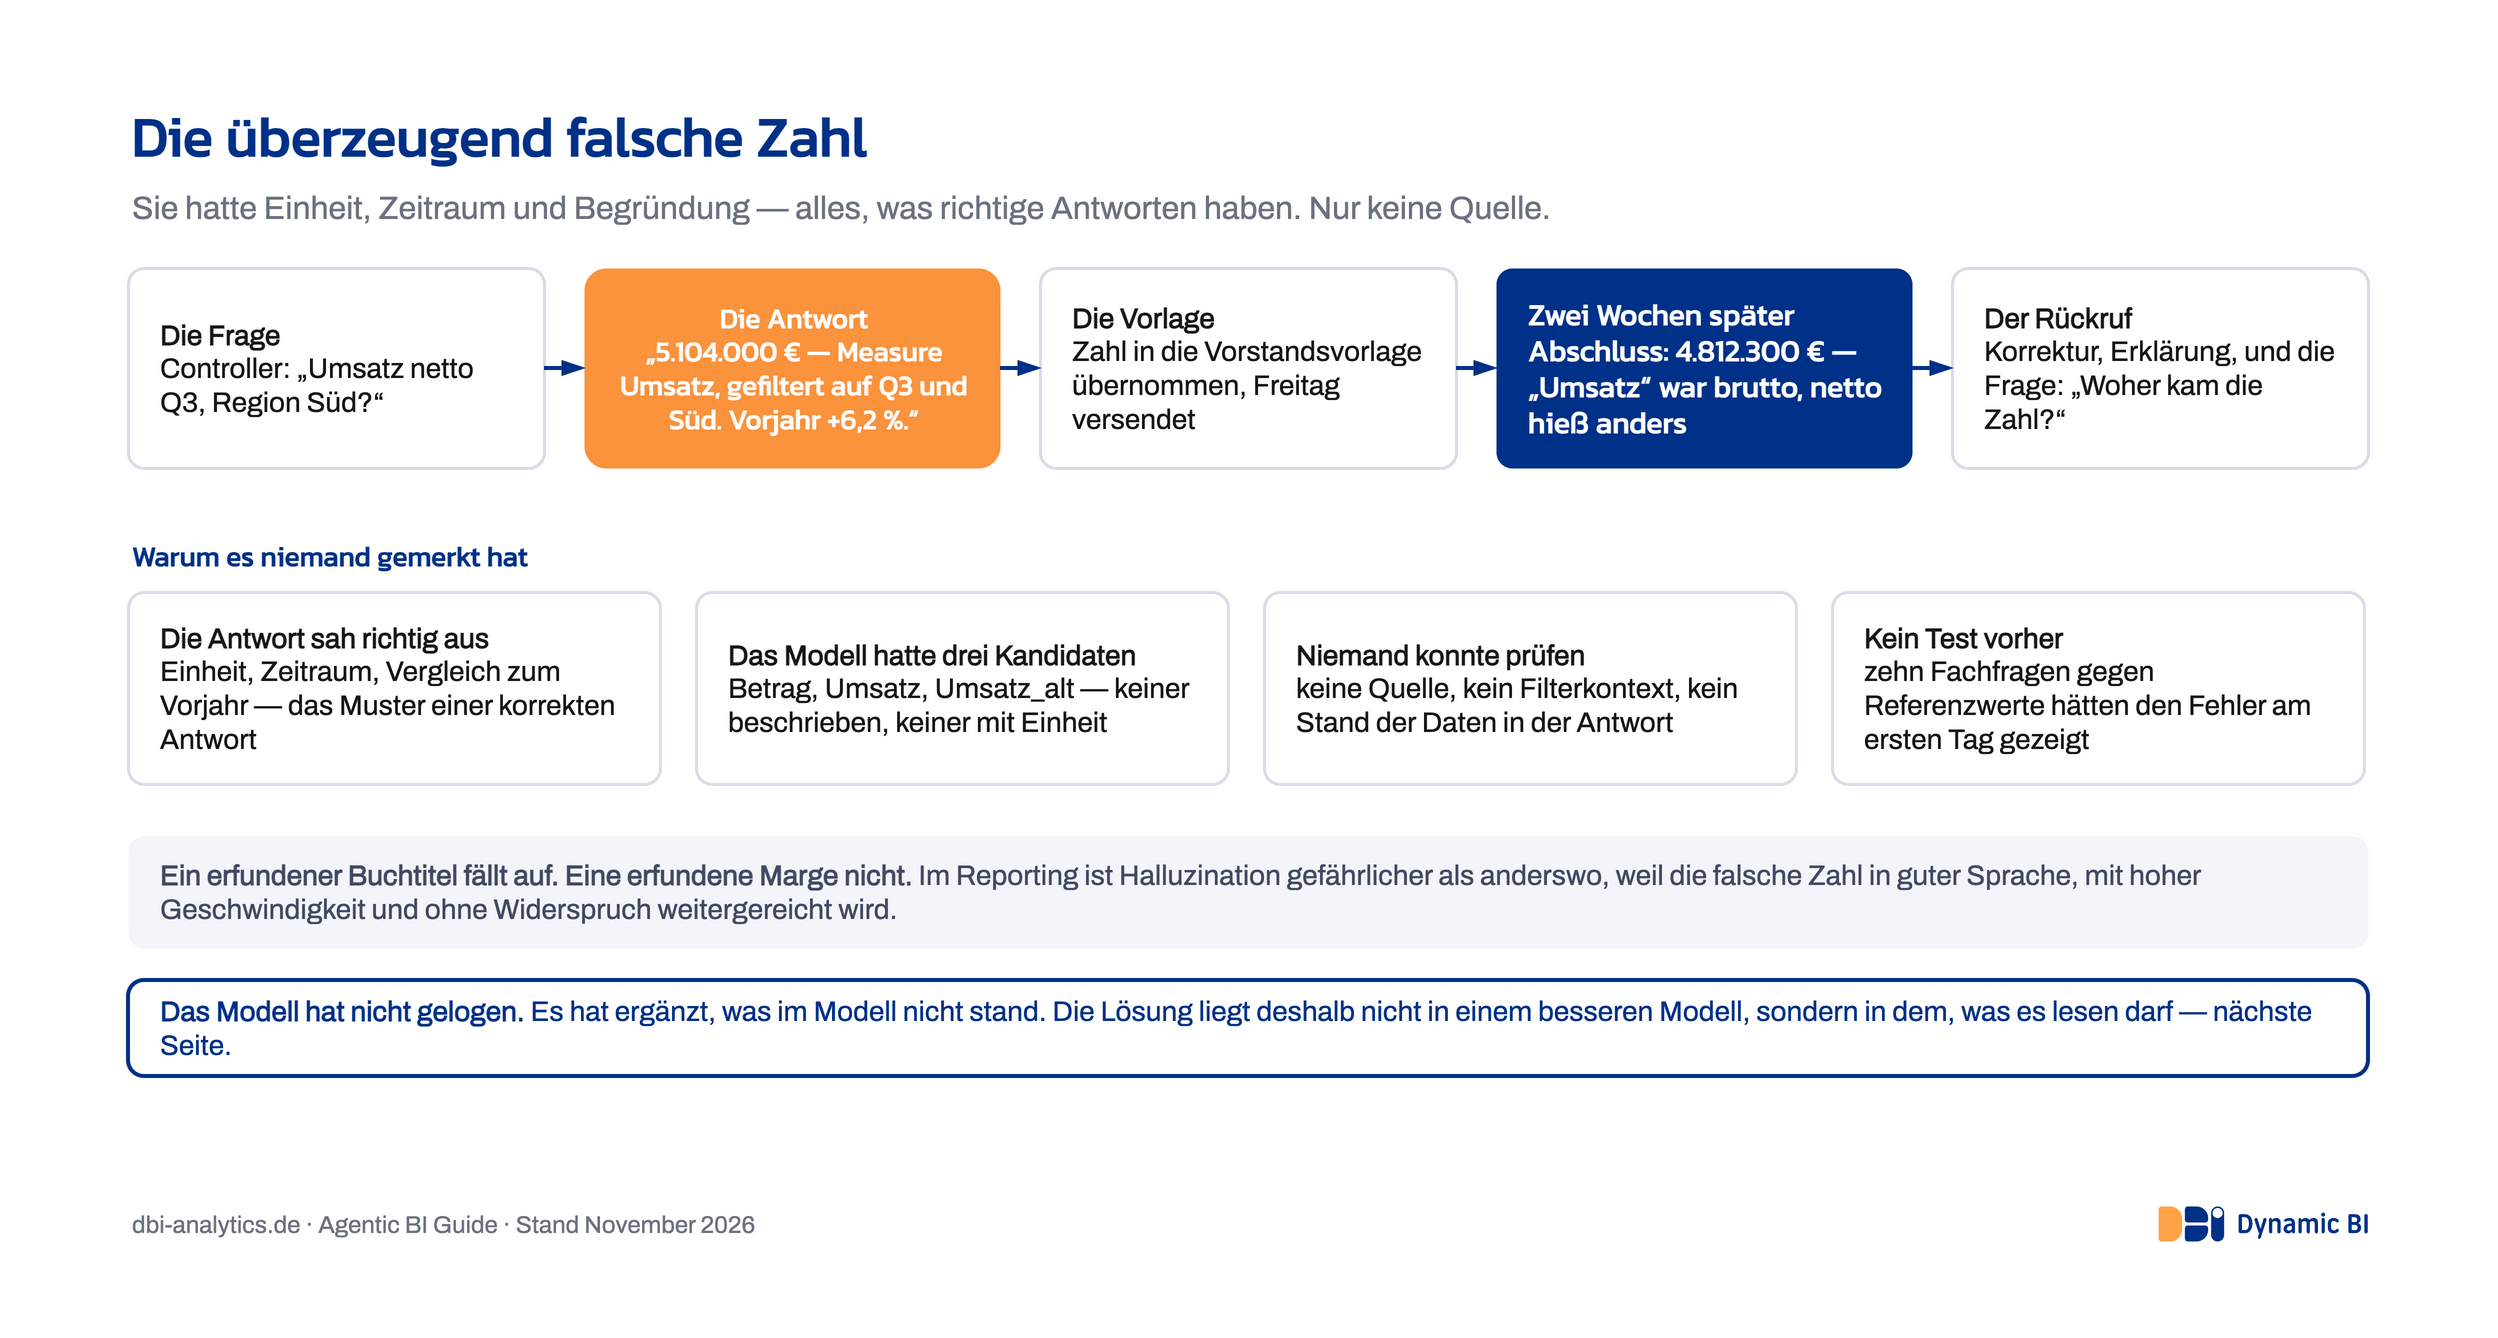
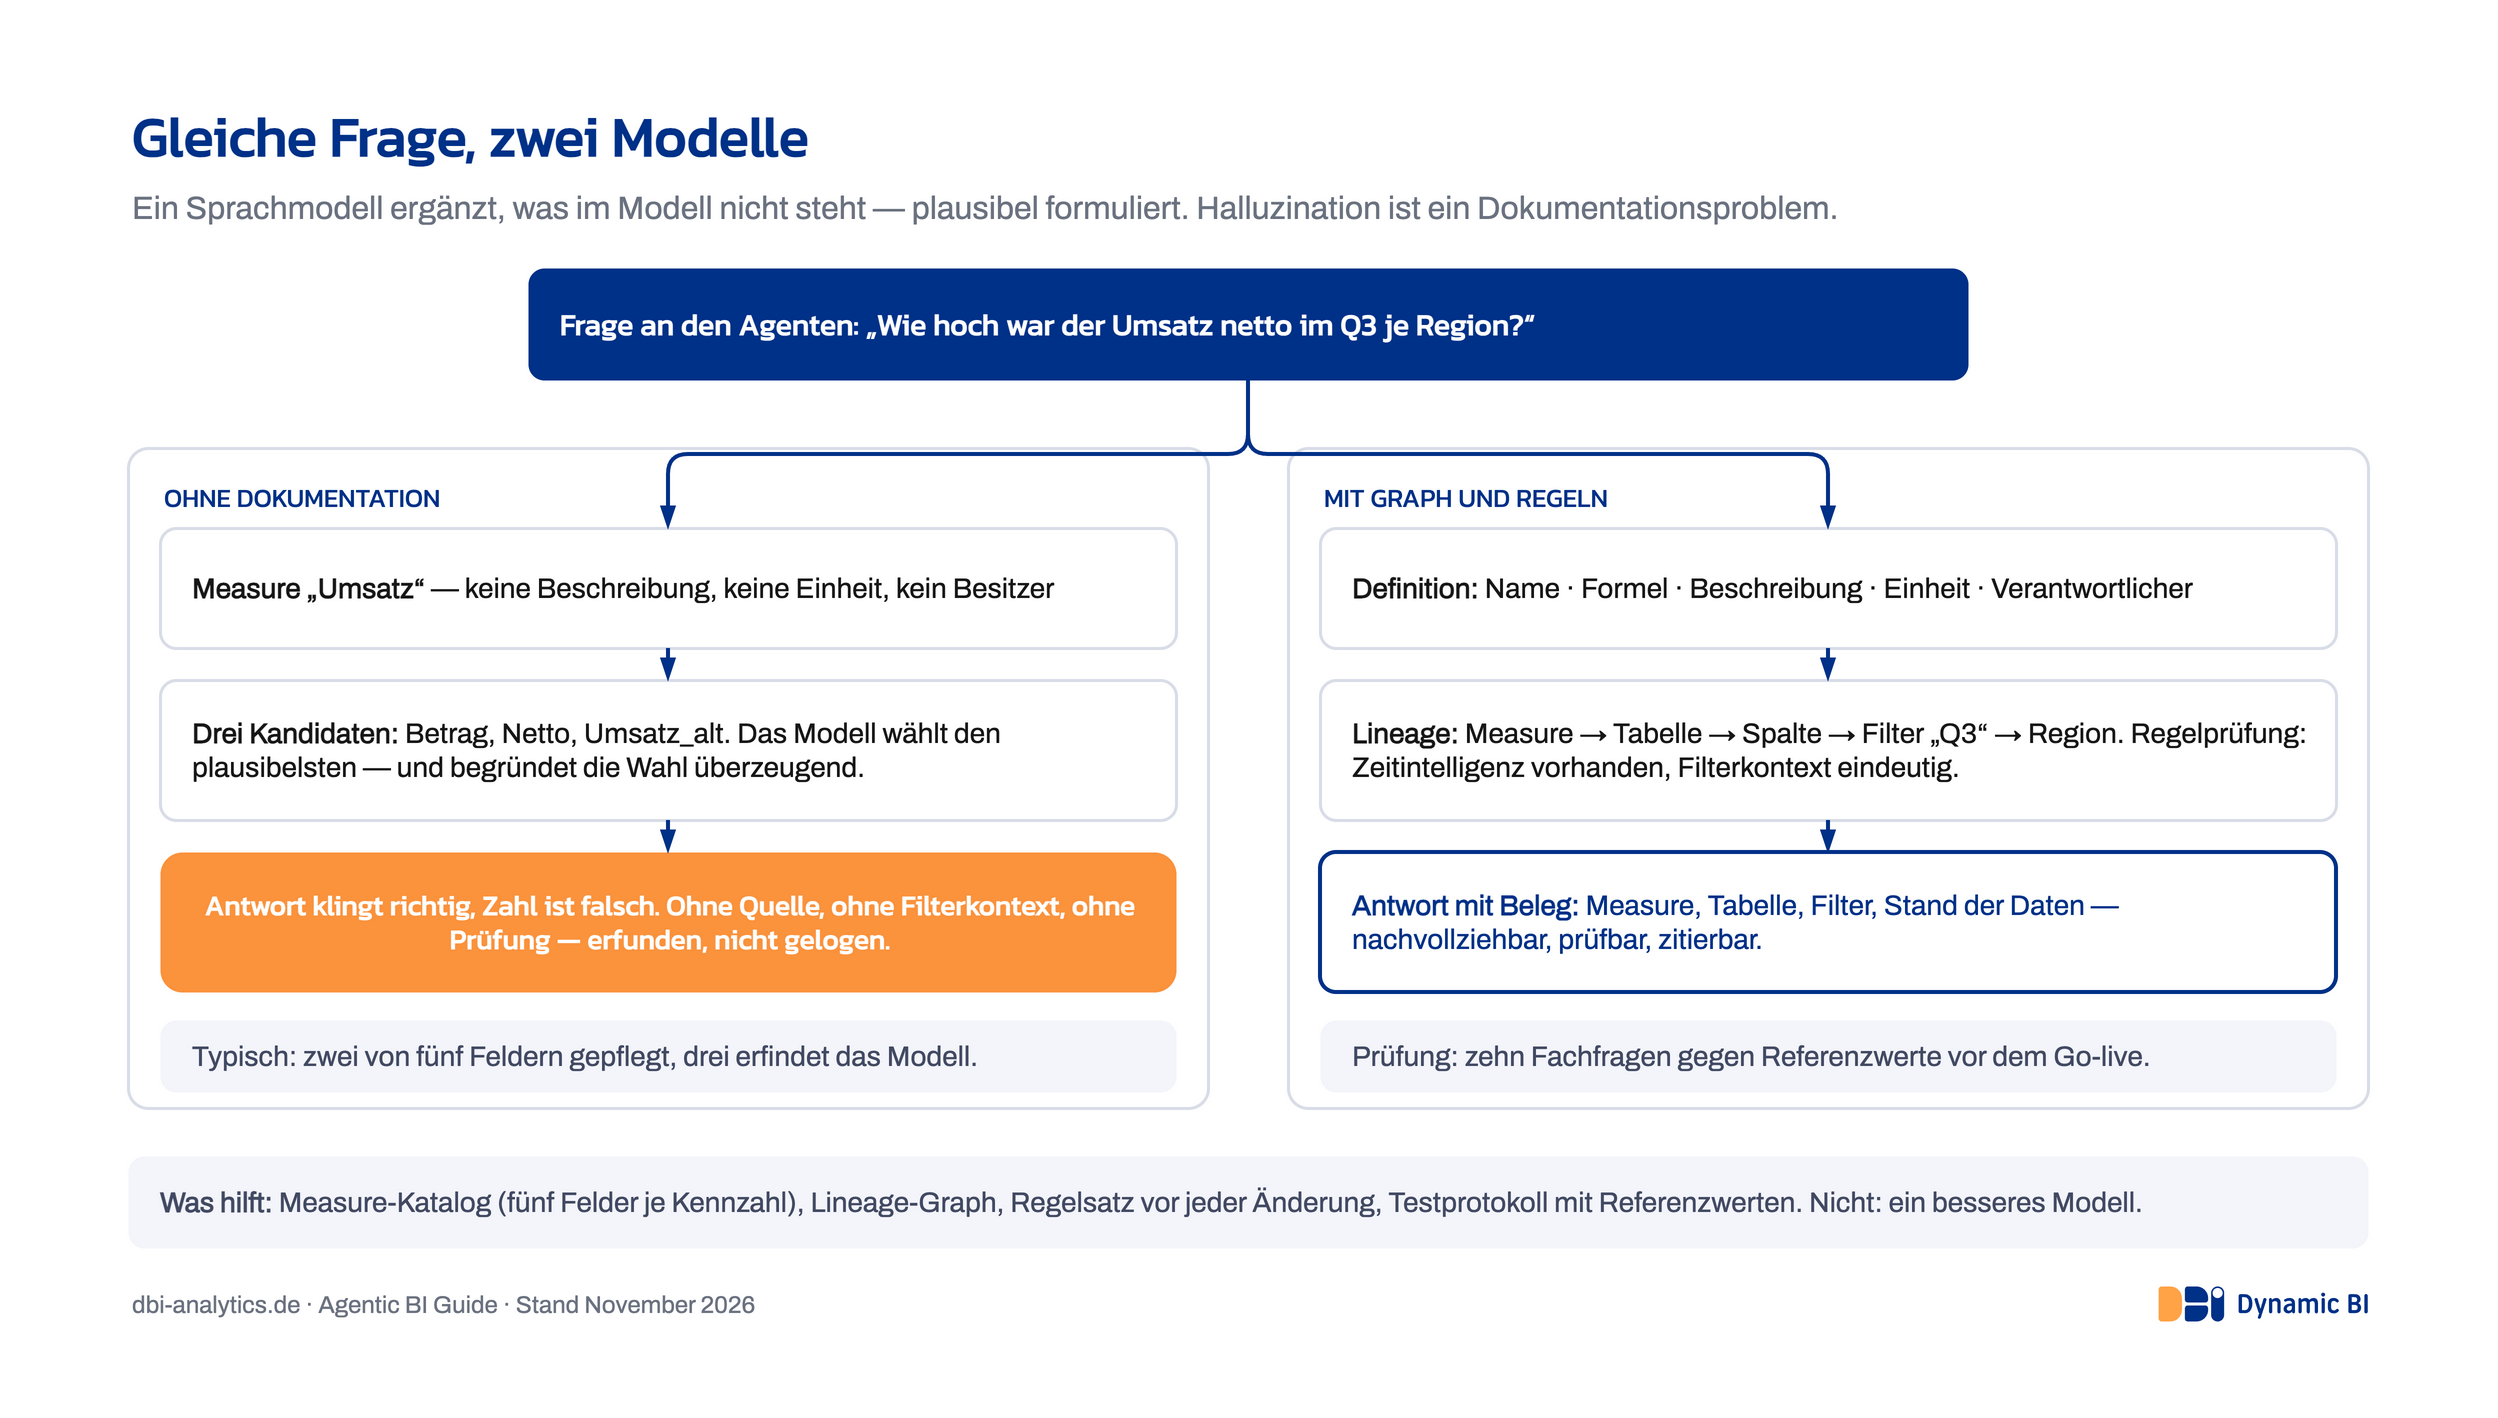
- KI-HalluzinationenWarum Agenten Geschäftslogik erfinden, und was es verhindert.
- Fabric Data Agents vs. CopilotDrei Wege zum Agenten im Vergleich — Lizenz, Sprache, Governance.
- Claude mit Power BIClaude Desktop und Claude Code: vom Prompt zur Reportseite.
- Talk with your DataWarum Text-to-SQL ohne Modell falsche Zahlen liefert.
- Agentic WorkflowSechs Schritte vom Mockup zur Abnahme.
- KI im ControllingZwölf Agentic-BI-Use-Cases mit Persona, Schmerz, Zahl.
- Was Agentic BI kostetTokenkosten, Copilot-Lizenzen, Festpreis statt Tagessatz.
- Power BI DokumentationRegelprüfung und Compliance-Score statt Pflichtübung.
- Legacy-Reporting inventarisierenLogik aus SAS, Crystal, SSRS, Qlik, Tableau extrahieren.
- BI OperationsBetrieb, Monitoring und Changes mit Agenten.
- Data Lineage für Agentic BIColumn-Level Lineage über SQL, Power BI und Excel — Live-Demo am Modellgraphen.
- Compliance und Datenqualität mit KI-AgentenTesting, Dokumentation und Compliance über ABIS automatisieren.
- Dashboard in a Day 2.0KI-Agenten über MCP direkt mit dem semantischen Modell verbinden.
- Talk with your DataMarketing-KPIs über Agents abfragen — Agentic Marketing in der Praxis.
- Alle Webinare→