

Gleiche Kennzahl, andere Formel
Drei Modelle, drei Measures „Umsatz“: einmal mit Storno, einmal ohne, einmal zum Tageskurs statt zum Stichtagskurs.
Power BI auf Snowflake ist in Minuten verbunden. Aufwendig wird die Logik: Kennzahlen, Mappings und Joins stecken in jedem Report einzeln und rechnen auseinander. Unsere Bestandsaufnahme zeigt mit einem Lineage-Graphen, welche Logik als View nach Snowflake gehört und welche in DAX bleibt.
Über den Snowflake-Connector in Power BI Desktop: Daten abrufen → Datenbank → Snowflake, dann Server-URL und Warehouse eintragen und Import oder DirectQuery wählen. Die Verbindung steht in wenigen Minuten. Der Aufwand liegt woanders: in der Logik, die danach in jedem Report entsteht.
Neue Verbindungen nutzen seit Juli 2025 standardmäßig die Connector-Implementierung 2.0 auf Basis des ADBC-Treibers. Microsoft empfiehlt die Anmeldung über Microsoft Entra ID. Daneben gibt es Schlüsselpaar-Authentifizierung, Service Principal und in Fabric die Workspace Identity. Benutzername und Passwort laufen aus, weil Snowflake die Anmeldung mit nur einem Faktor abschaltet.
Single Sign-on über Entra ID funktioniert nur mit DirectQuery. Dann gelten die Row Access Policies in Snowflake für jeden Betrachter einzeln. Ob die Aktualisierung im Power BI Service ein Gateway braucht, hängt von den Netzwerkregeln Ihres Snowflake-Kontos ab.
Stand: November 2026, geprüft gegen die Microsoft-Learn-Dokumentation zum Snowflake-Connector.
Für die meisten Reports ist Import die bessere Voreinstellung. DirectQuery lohnt sich, wenn Daten minutenaktuell sein müssen, das Modell zu groß für den Import ist oder die Zeilenberechtigung je Benutzer in Snowflake greifen soll. Zusammengesetzte Modelle mischen beides.
| Kriterium | Import | DirectQuery |
|---|---|---|
| Aktualität | Stand des letzten Refresh, geplant bis zu 8-mal täglich mit Pro, 48-mal mit Premium oder Fabric-Kapazität | Jede Abfrage liest den aktuellen Stand aus Snowflake |
| Antwortzeit | Schnell, die Daten liegen komprimiert im Semantikmodell | Hängt von Warehouse-Größe, SQL und Modell ab; jede Interaktion im Visual erzeugt Abfragen |
| Kosten in Snowflake | Rechenzeit nur beim Refresh | Rechenzeit bei jeder Abfrage auf dem Warehouse; Ergebnis-Cache und Aggregationen senken sie |
| Datenmenge | Begrenzt durch die Modellgröße der Lizenz, mit Pro 1 GB je Modell | Nicht durch die Modellgröße begrenzt |
| Berechtigungen | Row-Level Security im Power-BI-Modell | Mit Entra-ID-SSO wirken die Row Access Policies in Snowflake je Benutzer |
| DAX und Power Query | Voller Funktionsumfang | Power-Query-Schritte müssen nach SQL übersetzbar sein; manche DAX-Muster werden langsam |
Weil jede Kennzahl dort definiert wird, wo sie gebraucht wird: im Report. Jedes Power-BI-Modell rechnet Umsatz, Marge oder Pipeline mit eigenem DAX, eigenen Power-Query-Schritten und eigenen Filtern. Snowflake liefert dieselben Tabellen, die Reports machen daraus verschiedene Zahlen.
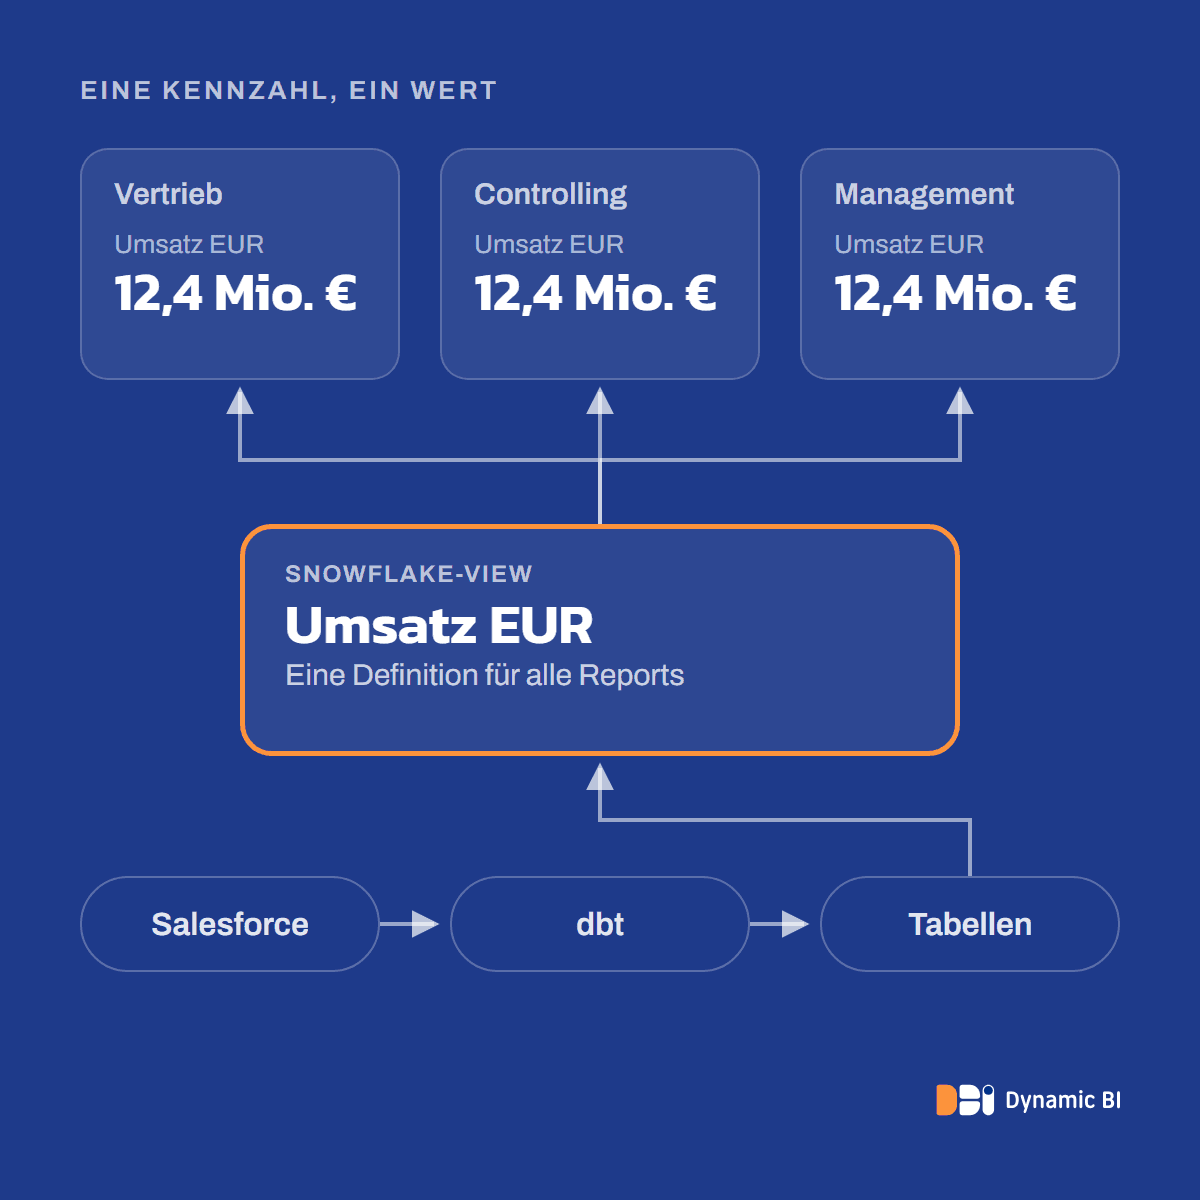
Kennzahlen zentralisieren heißt: eine Definition je Kennzahl, gepflegt in Snowflake und von allen Reports gelesen. Dafür muss zuerst sichtbar sein, wo welche Variante steckt. Das zeigt nur eine Data Lineage über alle Schichten, vom Quellsystem über dbt und die Views bis zum Measure im Visual.
Drei Modelle, drei Measures „Umsatz“: einmal mit Storno, einmal ohne, einmal zum Tageskurs statt zum Stichtagskurs.
Fakten und Dimensionen entstehen in M-Abfragen. Jeder Report baut sie neu, mit eigenen Filtern und eigener Join-Reihenfolge.
Länder-, Währungs- und Produktzuordnungen stehen als Literale in DAX, M oder SQL. Ändert sich ein Mapping, stimmt nur ein Teil der Reports.
Hängt an einem Datensatz eine n:m-Eigenschaft wie Tags, vervielfacht der Join die Zeilen. Die Summe wirkt plausibel, bis jemand nachrechnet.
Werden Stichtags-Snapshots summiert statt gefiltert, wächst die Pipeline mit jedem Stichtag. Fehlende Wechselkurse lassen Beträge still aus der Summe fallen.
Einzelne Reports lesen direkt aus Landing- oder Rohschichten. Dort gelten weder die geprüfte Logik noch die Zugriffsregeln der Datenprodukte.
Was mehrere Reports brauchen, kommt als View auf die bestehenden Tabellen nach Snowflake: Kennzahl-Definitionen, Mappings, Hierarchien und Schlüssel. In DAX bleibt, was vom Filterkontext abhängt, etwa Time Intelligence oder Anteile an der aktuellen Auswahl.
So wird Snowflake zum Data Warehouse für Power BI im eigentlichen Sinn. Die Views enthalten nur die Spalten, die Reports tatsächlich lesen, mit kanonischen Namen und Einheiten. Die Datenprodukte hängen nicht mehr an einzelnen Reports, und mehrere Teams bauen darauf eigene Reports, ohne Logik zu kopieren.
dbt erweitern wir nur, wenn die Tabellen die Logik nicht tragen: bei fehlenden Attributen, fehlender Historie oder zu langsamen Abfragen. Das hält die Änderung klein und den bestehenden Ladeprozess unangetastet.

Die Faustregel je Art von Logik:
| Logik | Snowflake | Power BI (DAX) |
|---|---|---|
| Kennzahl mit fester Definition, etwa Umsatz EUR oder Marge | Spalte in der View, eine Definition für alle Reports | Nur noch SUM über die fertige Spalte |
| Währungs-, Länder- und Produkt-Mappings | Mapping-Tabelle oder Mapping-View statt Literal | Entfällt |
| Joins, Filter und Typkonvertierung aus Power Query | In der View, gemeinsame Grundlage aller Modelle | Power Query lädt nur noch |
| Zeit-, Regions- und Produkthierarchien | Konforme Dimensions-Views, einmal gepflegt | Hierarchie im Modell auf die fertigen Spalten setzen |
| Time Intelligence wie Vorjahr oder YTD | Nicht sinnvoll, hängt von der Auswahl im Report ab | Bleibt in DAX, auf Basis einer Datumstabelle |
| Anteile, Rankings, SELECTEDVALUE | Nicht abbildbar | Bleibt in DAX |
| Zeilenberechtigung | Row Access Policy, wirkt bei DirectQuery mit SSO je Benutzer | Row-Level Security im Modell bei Import oder technischem Benutzer |
Snowflake liest ein Power-BI-Modell als .pbix oder .pbit ein und erzeugt daraus eine Semantic View für Cortex Analyst. Tabellen, Beziehungen und die meisten Measures kommen mit, Measures werden zu Metriken. Time Intelligence, SELECTEDVALUE, Calculation Groups und berechnete Tabellen übernimmt Snowflake nicht.
Die Datei darf höchstens 250 MB groß sein. Snowflake liest das ganze Semantikmodell ein, nicht nur die Tabellen eines Reports. Measures, die im Report statt im Modell liegen, fehlen danach. Tabellen aus anderen Quellen als Snowflake oder mit leeren Parametern werden verworfen.
Wer auf Semantic Views umsteigen will, muss vorher wissen, welcher Teil seiner Logik übertragbar ist. Das beantwortet die Bestandsaufnahme: Sie ordnet jedes Measure zu, ob Snowflake es übernimmt, ob es als View besser aufgehoben ist oder ob es in DAX bleibt.
Stand: November 2026, geprüft gegen die Snowflake-Dokumentation zum Power-BI-Import.
| Element im Power-BI-Modell | Übernahme | Details |
|---|---|---|
| Tabellen | Übernommen | Tabellen aus Snowflake mit Namen, Spalten und Datentypen |
| Beziehungen | Übernommen | Many-to-many nur, wenn eine Seite einen eindeutigen Schlüssel hat |
| Measures | Größtenteils | Werden zu Metriken, auch über mehrere Tabellen; CALCULATE, FILTER, ALL und REMOVEFILTERS funktionieren |
| Berechnete Spalten | Teilweise | Nur Berechnungen innerhalb einer Tabelle |
| Power-Query-Schritte | Teilweise | Umbenennungen und neue Spalten, die sich in SQL ausdrücken lassen |
| Time Intelligence | Nicht übernommen | TOTALYTD, SAMEPERIODLASTYEAR, PREVIOUSMONTH |
| Auswahlabhängige Funktionen | Nicht übernommen | SELECTEDVALUE, ALLSELECTED, ISFILTERED |
| Calculation Groups und berechnete Tabellen | Nicht übernommen | Werden verworfen, ebenso alle Measures, die darauf zugreifen |
| Statistik und Tabellenfunktionen | Nicht übernommen | MEDIAN, PERCENTILE, STDEV, RANKX, TOPN, SUMMARIZE |
In fünf Phasen: Zugänge klären, Assets erfassen, Lineage-Graph bauen, Thesen prüfen, Maßnahmen ableiten. Jeder Befund aus Dokumentation oder Fachbereich ist zunächst eine These. Zur Maßnahme wird er erst, wenn Code, Metadaten oder Konfiguration ihn belegen.
Der Lineage-Graph reicht von den Quellsystemen über dbt und die Snowflake-Views bis zu jedem Measure, jeder berechneten Spalte und jedem Visual in Power BI. Jedes Objekt ist ein Knoten mit Herkunft und Beleg. Darauf prüfen wir: Welche Kennzahlen sind doppelt definiert, welche View-Spalten liest kein Report, welche Reports greifen an den Datenprodukten vorbei?
Den Graphen bauen wir in ABIS, unserem Werkzeug für agentische BI-Governance. KI-Agenten beantworten darauf Herkunftsfragen wie „Woher kommt Umsatz EUR?“ und schlagen vor, welche Logik in welche View wandert. Regeln auf dem Graphen prüfen nach jeder Änderung, ob das Modell noch stimmt. So arbeiten die Agenten schnell, aber innerhalb geprüfter Grenzen.
Scan und Erhebung bauen wir als Programm, nicht als Handarbeit. Jeder Lauf liefert dieselben Strukturen und lässt sich für weitere Datenprodukte oder nach Änderungen wiederholen, mit Differenz zum letzten Stand.

Lesende Rollen in Snowflake, im dbt-Repository und in Power BI anfordern und testen. Sie beschaffen intern, wir liefern die Checkliste je System.
Die 2 bis 4 priorisierten Reports als PBIP sichern und per Programm scannen: Datenquellen, M-Abfragen, Fakten- und Dimensionsableitung, Measures, genutzte Views.
dbt-Manifest und Snowflake-Systemviews auslesen, mit dem Power-BI-Scan zusammenführen, fehlende Kanten und Spaltenherkunft ergänzen. Ergebnis ist ein Knowledge Graph, abfragbar für KI-Agenten.
Jede These gegen Code, Metadaten, Konfiguration und Graph prüfen. Ergebnis je These: bestätigt oder widerlegt, mit Beleg und, wo möglich, mit einer Kennzahl zur Auswirkung.
Nur für bestätigte Thesen: Ziel, Akzeptanzkriterien, Aufwand in Personentagen, Priorität. Abstimmung mit Ihrem Team, danach als Workitems angelegt.
Ein Industriekonzern lädt CRM-Daten aus Salesforce über dbt nach Snowflake und stellt sie als Views für Power BI bereit. Eine Analyse der View-Dokumentation hat 17 Befunde ergeben, ohne Code oder Daten zu sehen.
In der Bestandsaufnahme prüfen wir diese Befunde zusammen mit einer weiteren These aus dem Power-BI-Teil als 18 Thesen gegen Code, Metadaten und Graph. Der Umfang: ein Datenprodukt, 2 bis 4 Reports, 13 Personentage einschließlich 30 % Puffer.
Die Reports müssen auf Snowflake umgestellt werden: Verbindungen, M-Abfragen und eingebettetes SQL. DAX bleibt in den meisten Fällen unverändert, weil es auf dem Semantikmodell rechnet und nicht auf der Datenbank. Der Wechsel ist trotzdem der beste Zeitpunkt, Logik nach Snowflake zu verlagern.
Snowflake bietet dafür SnowConvert AI. Das Werkzeug stellt Power-BI-Reports im Format .pbit von SQL Server, Azure Synapse, Oracle, Teradata, Redshift oder PostgreSQL auf Snowflake um: Tabellen, Views und eingebettete SQL-Abfragen. Die übrigen M-Schritte bleiben erhalten. DAX und Geschäftslogik erwähnt die Dokumentation nicht, komplexe SQL-Abfragen brauchen Nacharbeit.
Wer nur umstellt, nimmt doppelte Kennzahlen, hartkodierte Mappings und Power-Query-Joins mit auf die neue Plattform. Die Bestandsaufnahme zeigt vor dem Umzug, welche Logik in Views wandert und welche Reports danach dieselbe Kennzahl lesen.
Sie lösen kein Data Warehouse ab, sondern Tableau, Cognos, SSRS oder einen Power-BI-Tenant? Diese Wege beschreibt unsere Seite zur Power BI Migration.
| Kriterium | Nur umstellen | Umstellen und Logik verlagern |
|---|---|---|
| Aufwand vorab | Gering, teilweise automatisiert | 2 bis 3 Wochen Bestandsaufnahme vor dem Umbau |
| Kennzahlen danach | Weiter je Report definiert | Eine Definition je Kennzahl in Snowflake |
| Nächster Report | Kopiert Logik aus einem bestehenden Report | Liest fertige Spalten aus der View |
| Änderung an einer Spalte | Wirkung auf andere Reports unbekannt | Betroffene Reports und Modelle stehen im Graphen |
Ein Datenprodukt in Snowflake mit seinen dbt-Modellen und 2 bis 4 Power-BI-Reports, in 2 bis 3 Wochen zum Festpreis von 9.980 €. Wir lesen ausschließlich Metadaten: Objekte, Spalten, Abhängigkeiten und Konfiguration. Geschäftsdaten sehen wir nicht, Prüfabfragen liefern nur Kennzahlen.
Die Bestandsaufnahme ist ein bezahltes Audit und geht tiefer als die kostenfreie Fabric-Analyse. Die Fabric-Analyse zählt Ihren Bestand für eine Migration nach Microsoft Fabric. Die Bestandsaufnahme prüft die Logik eines Datenprodukts bis zur einzelnen Kennzahl und belegt jede Aussage.
Nicht im Festpreis enthalten ist die Bereinigung selbst: Logik in Views verlagern, Compliance-Regeln einrichten, Reports umstellen. Diese Pakete schätzen wir im Maßnahmenkatalog und beginnen sie erst nach Ihrer Freigabe.
Aufwand enthalten
13 PT
10 PT netto plus 30 % Komplexitätspuffer
Festpreis
9.980 €
zzgl. USt. · 2–3 Wochen · abgerechnet wird das Ergebnis, nicht der Aufwand
Umfang
1 + 2–4
ein Datenprodukt plus 2 bis 4 Power-BI-Reports aus Ihrer Prioritätenliste
| Arbeitsblock | Aufwand |
|---|---|
| ZugängeLesende Rollen anfordern, abstimmen und testenPositionen 1 | 0,5 PT |
| ErfassungReports scannen, Lineage erhebenPositionen 2–3 | 3,0 PT |
| AnalyseKnowledge Graph, Regelentwurf, ThesenprüfungPositionen 4–5 | 5,0 PT |
| ÜbergabeMaßnahmenkatalog und AbstimmungsterminPositionen 6 | 1,5 PT |
| Puffer30 % auf 10 PT nettoPositionen 7 | 3,0 PT |
| Gesamt · 7 Positionen | 13 PT |
| # | Position | PT |
|---|---|---|
| Zugänge | 0,5 PT | |
| 1 | Zugänge beschaffen und testenSnowflake, dbt-Repository, Power BI und Projekt-Repository, mit Ihren Administratoren abgestimmt | 0,5 |
| Erfassung | 3,0 PT | |
| 2 | Power-BI-Assets einsammeln und scannen2 bis 4 Reports als PBIP: Datenquellen, M-Abfragen, Fakten- und Dimensionsableitung, genutzte Views | 1,5 |
| 3 | Lineage aufbauen und ergänzendbt-Manifest und Snowflake-Systemviews, nur lesend; Spaltenherkunft und Kennzahlen ergänzt; als wiederholbares Programm | 1,5 |
| Analyse | 5,0 PT | |
| 4 | Knowledge Graph aufbauen und analysierenKnoten- und Kantentypen, Abhängigkeiten, doppelte Logik, Zugriffspfade; erster Regelentwurf, mit Ihnen abgestimmt | 3,0 |
| 5 | Thesen prüfenJede These gegen Code, Metadaten, Konfiguration und Graph; Auswirkung als Kennzahl | 2,0 |
| Übergabe | 1,5 PT | |
| 6 | Maßnahmenkatalog ableitenNur bestätigte Thesen: Ziel, Akzeptanzkriterien, Aufwand, Priorität; Abstimmungstermin inkl. Vor- und Nachbereitung | 1,5 |
| Puffer | 3,0 PT | |
| 7 | KomplexitätspufferUnbekannter Code-Stand, Zugänge, Umgebung | 3,0 |
Wartezeiten auf Zugänge zählen nicht zur Laufzeit. Die 2 bis 3 Wochen beginnen, sobald alle lesenden Zugriffe getestet sind.
Alle Zugriffe sind lesend und betreffen nur Metadaten. Zwei Ausnahmen: ein CI-Job im dbt-Repository und ein Projekt-Repository für die Ergebnisse. Lizenzen und Konten stellen Sie bereit.
Optional, wenn intern freigegeben: ein Snowflake MCP Server mit derselben Leserolle. Dann stellen KI-Agenten Metadaten- und Prüfabfragen direkt gegen Snowflake.

30–45 Minuten · remote
Festpreis zzgl. USt. · 2–3 Wochen · remote
geschätzt im Maßnahmenkatalog
30–45 Minuten Erstgespräch, kostenfrei und ohne Verpflichtung. Danach wissen Sie, ob die Bestandsaufnahme passt und welche Zugänge wir brauchen.